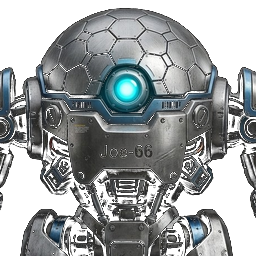
 Mein eigener KI-Assistent
Angefangen hat es mit einem simplen Chatfenster auf dem Spiele-PC. Heute läuft Joe-Bot rund um die Uhr auf meinem Server – mit Gedächtnis, Stimme, eigenem Postfach und einer Leitstelle im Stil eines Raumschiff-Cockpits.
Zwei Gehirne
Joe-Bot kann zwischen zwei „Gehirnen“ wechseln: einem lokalen Sprachmodell, das auf einer Grafikkarte im Server läuft und nichts kostet, und Claude für die schwierigen Fragen. Ein Knopf schaltet um – und leuchtet, wenn das sparsame lokale Gehirn dran ist.
Ein Gedächtnis, das wächst
Jede Unterhaltung landet in einem Notizbuch. Fragt man später etwas Ähnliches, holt Joe-Bot die passenden Erinnerungen hervor. Nachts baut ein „Archivar“ daraus ein Netz, wer und was zusammengehört. Was das große Gehirn herausfindet, merkt sich Joe-Bot mit Datum – so wird auch das kleine Gehirn mit der Zeit klüger.
Hände – aber mit Erlaubnis
Joe-Bot darf nachschauen, so viel er will. Sobald er aber etwas verändern möchte – ein Licht schalten, einen Dienst neu starten, eine Mail beantworten –, landet der Auftrag im Hangar. Dort tippe ich ✔ oder ✘. Vorher passiert nichts. Das war mir von Anfang an wichtig: ein Assistent, kein Autopilot.
Was er inzwischen alles kann
- Status vom ganzen Server auf einen Blick, auf Wunsch per Sprache
- Lichter und Heizung schalten, Kameras zeigen
- Postfächer sortieren, Wichtiges melden, Antworten vorschlagen
- Im Internet nachschlagen – mit einem Wächter, der aufpasst, dass nichts Internes nach draußen geht
- Vor Lebensmittel-Rückrufen warnen, direkt aufs Handy
- Jeden Morgen einen Tagesbericht schicken
Selbst ausprobieren: dein eigener KI-Chat in 15 Minuten
Joe-Bot ist über Wochen gewachsen – aber der Kern lässt sich an einem Abend nachbauen: ein Sprachmodell, das komplett bei dir zu Hause läuft (Ollama), und eine Chat-Oberfläche wie bei ChatGPT (Open WebUI). Kein Konto, keine Kosten, nichts verlässt das Haus.
- Ollama starten – das „Gehirn“:
Shelldocker run -d --name ollama --restart unless-stopped -p 11434:11434 -v ollama:/root/.ollama ollama/ollama
- Ein Modell laden. Für den Anfang ein kleines, das auch ohne Grafikkarte flüssig läuft:
Shelldocker exec -it ollama ollama pull gemma3:4b
docker exec -it ollama ollama run gemma3:4b "Erklär mir in zwei Sätzen, was ein Homelab ist."
- Chat-Oberfläche starten:
Shelldocker run -d --name open-webui --restart unless-stopped -p 3000:8080 \
  -e OLLAMA_BASE_URL=http://IP-DES-RECHNERS:11434 \
  -v open-webui:/app/backend/data ghcr.io/open-webui/open-webui:main
http://IP-DES-RECHNERS:3000 öffnen, Admin-Konto anlegen, oben das Modell „gemma3:4b“ wählen
und losschreiben. Das Mikrofon-Symbol im Chat funktioniert auch – dafür muss die Seite aber über HTTPS laufen.